SSD 수명 확인법과 교체 기준 총정리: 크리스털디스크인포 핵심 SMART 값 분석
SSD 수명 확인법과 교체 시기를 판단할 때 크리스털디스크인포(CrystalDiskInfo) 상단의 '건강 상태 수명 퍼센트(%)'만 확인하고 안심하는 것은 매우 위험한 접근 방식입니다. SSD 교체를 결정짓는 결정적 팩터는 마모도 퍼센트가 아니라 하드웨어 셀 불량을 직접 알리는 재할당·보류·회복 불가 섹터(05·C5·C6)의 원시값(RAW)입니다.
하루 20GB 수준을 기록하는 일반 사무·게이밍 PC 환경에서 1TB SSD의 600TBW(총 쓰기량) 보증 한도를 모두 소진하려면 산술적으로 약 82년이 소요되므로, 일반 사용자가 셀 쓰기 마모로 SSD 고장을 겪을 확률은 극히 드뭅니다. 오히려 수명 98% 상태에서도 컨트롤러 급사나 정전 시 매핑 테이블 손상으로 시스템 인식이 정지되는 사례가 빈번합니다.
따라서 SMART 지표는 디스크 고장을 사전에 100% 방어하는 도구가 아니라 '즉각 교체 및 백업 우선순위'를 결정하는 기술적 진단 도구로 활용해야 합니다. SATA 및 NVMe 인터페이스별 핵심 진단 수치와 교체 판단 기준을 기술적으로 상세히 분석합니다.
30초 긴급 진단: 크리스털디스크인포 상태별 즉각 조치 가이드
크리스털디스크인포 구동 시 화면 상단에 출력되는 파랑(정상), 노랑(주의), 빨강(위험), 회색(불명)의 건강 상태 표시는 소프트웨어 기본 임계값에 기반한 1차 판정일 뿐입니다. 고급 설정 메뉴에서 임계값을 임의 조정하면 동일 디스크의 상태 색상이 달라질 수 있으므로, 하단 SMART 항목의 원시값(RAW Value)을 직접 대조해야 합니다.
| 진단 화면 상태 | 기술적 상태 분석 | 엔지니어 권장 조치 절차 |
|---|---|---|
| 정상(파랑) / 잔존 수명 90% 이상 / 원시값 전 항목 0 | 낸드 셀 및 전송 채널 무결성 유지 상태 | 정상 구동 유지, 6개월 주기 정기 모니터링 |
| 정상(파랑) / 잔존 수명 50~80% / 원시값 0 | 정상적인 쓰기/지우기 사이클 마모 진행 | 하드웨어 교체 불필요, 정기 데이터 백업 루틴 점검 |
| 정상 표시 중 C7(UltraDMA CRC) 원시값 지속 증가 | 드라이브 셀 결함이 아닌 SATA 데이터 케이블/포트 접촉 불량 | SATA 케이블 교체, 메인보드 포트 변경 재장착 |
| 주의(노랑) / 05, C5, C6 원시값 1 이상 기록 | 물리적 불량 셀 발생 및 읽기 파이프라인 실패 | 신규 쓰기 즉시 중단, 전체 백업 후 드라이브 교체 |
| 주의(노랑) / 마모도 퍼센트만 0% 또는 임계 도달 | 제조사 보증 쓰기량(TBW) 소진 단계 | 백업 완료 후 신규 드라이브로 계획 교체 진행 |
| 위험(빨강) 또는 간헐적 장치 인식 드랍 | 컨트롤러 치명적 결함 또는 펌웨어 루프 진입 | 추가 전원 인가 최소화, 최우선 데이터 복구 진행 |
| 불명(회색) 상태 표시 | 외장 브릿지 칩셋 또는 RAID 컨트롤러의 SMART 패스스루 미지원 | 메인보드 온보드 SATA/M.2 슬롯 직결 후 재측정 |
SSD 내구도와 TBW 수치 분석: 쓰기 한도로 디스크가 사망할 확률
SSD 내구도의 핵심인 낸드 플래시는 플로팅 게이트 또는 차지 트랩 절연막 내에 전자를 저장하는 물리적 구조를 가집니다. 데이터 쓰기와 소거(P/E Cycle)가 반복되면 절연막이 열화되어 전하 유지 능력이 저하됩니다. 즉, SSD 수명은 단순히 PC 전원을 켜 둔 작동 시간이 아니라 '낸드 블록을 지우고 다시 쓴 횟수'에 의해 결정됩니다. 이는 기계적 모터와 헤드 마모가 누적되는 HDD와는 근본적으로 다른 메커니즘입니다.
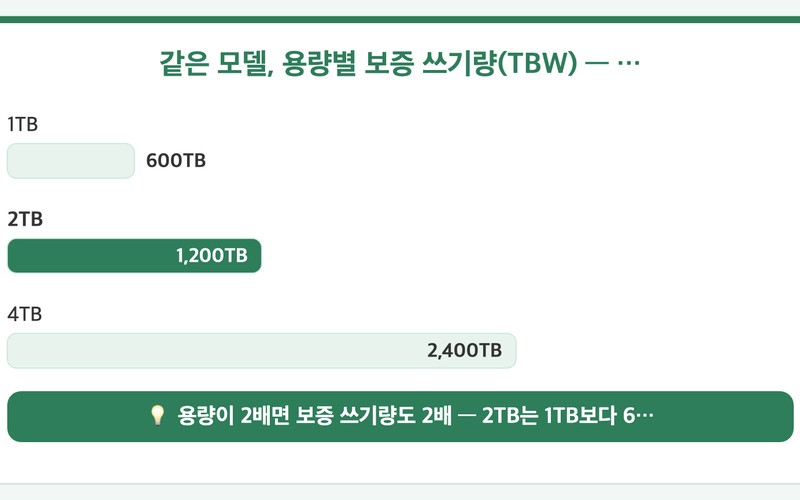
컨슈머 시장의 주력인 TLC(Triple Level Cell) 낸드는 약 1,000~3,000회의 P/E 사이클 내구도를 가지며, QLC(Quad Level Cell)는 수백~1,000회 수준으로 설계됩니다. 제조사는 이를 사용자가 직관적으로 관리할 수 있도록 TBW(Total Bytes Written, 총 쓰기량) 단위로 표기합니다. 삼성전자 990 PRO를 기준으로 살펴보면 1TB 모델은 600TBW, 2TB는 1,200TBW, 4TB는 2,400TBW의 내구성을 보증하며, 보증 조건은 '구입 후 5년 또는 TBW 초과 시점 중 먼저 도달하는 것'으로 제한됩니다.
일반 PC 사용 패턴(OS 구동, 오피스 문서, 웹 서핑, 패키지 게임)에서 일일 쓰기량은 평균 20GB 수준입니다. 1TB 용량(600TBW)의 SSD를 기준으로 이를 소진하려면 30,000일, 즉 산술적으로 약 82년이 소요됩니다. 4K 영상 편집 및 대용량 렌더링으로 일일 50GB를 기록하는 전문 작업자 환경이라도 12,000일, 약 32년이 걸립니다. 따라서 일반적인 워크로드에서 보증 쓰기량 초과로 SSD가 작동 정지될 가능성은 매우 낮습니다.
NVMe 표준 사양 문서에 명시된 'Percentage Used(사용량)' 값 100은 제조사가 설정한 설계 내구도를 100% 충족했음을 의미할 뿐, 디스크의 즉각적인 하드웨어 고장을 가리키지 않습니다. 100%에 도달하거나 이를 초과하더라도 낸드 셀 결함이 없다면 읽기/쓰기 동작은 정상 지속됩니다. 수명 % 수치는 단순 소진 추정치이므로 교체 여부를 단독 결정하는 지표로 삼아서는 안 됩니다.
SATA SSD 정밀 분석: 0이 아니면 즉각 백업해야 할 치명적 SMART 값
2.5인치 SATA 인터페이스 SSD는 과거 회전식 하드디스크의 레거시 SMART 속성 구조를 그대로 차용하고 있습니다. 따라서 16진수로 표기되는 원시값(RAW) 열의 정밀 분석이 필수적이며, 아래 명시된 3대 치명 속성은 원시값이 '0'이 아닐 경우 즉각적인 교체 경고로 해석해야 합니다.
| 속성 ID | SMART 파라미터 명칭 | 정상 기준값 | 0 초과(원시값 발생) 시 하드웨어 분석 및 진단 기준 |
|---|---|---|---|
| 05 | Reallocated Sector Count (재할당 섹터 수) | 0 | 손상된 블록의 데이터를 예비 영역(Spare Area)으로 재배치한 횟수. 원시값이 지속 상승하면 낸드 열화 임계치 도달 신호 |
| C5 | Current Pending Sector Count (보류 중 섹터 수) | 0 | ECC 읽기 실패로 판정이 보류된 불안정 섹터. 전원 차단 시 데이터 증발 위험이 높은 1급 위험 신호 |
| C6 | Offline Uncorrectable Sector (회복 불가 섹터 수) | 0 | ECC 알고리즘으로 복구 불가능한 영구 섹터 손상. 해당 주소 데이터가 전손되었음을 의미하므로 즉각 교체 필수 |
| C7 | UltraDMA CRC Error Count | 0 | SATA 인터페이스 통신 체크섬 오류. 낸드 셀 손상이 아닌 SATA 데이터 케이블 불량 및 메인보드 포트 노이즈로 발생 |
| B1 / AD | Wear Leveling Count / Average Erase Count | 낮을수록 양호 | 셀 간 마모 평준화 동작 횟수. 정상 사용에 따라 점진적으로 증가하는 정상적 지표 |
| B3 | Used Reserved Block Count (사용된 예비 블록 수) | 0에 수렴 | 불량 섹터 대체를 위해 팩토리 예비 블록을 소모하기 시작한 지표. 증가 시 여유 마진 고갈 위험 |
| B5 / B6 | Program Fail Count / Erase Fail Count | 0 | 물리 셀에 전압 인가 쓰기/소거 작업 자체가 실패한 횟수. 낸드 다이의 하드웨어 고장 직결 수치 |
크리스털디스크인포의 현재값·최저값·임계값은 100 기준에서 감산되는 벤더별 정규화 수치이므로, 교체 판단 시에는 반드시 우측의 '원시값(RAW Value)'을 10진수로 변환해 확인해야 합니다. SSD 컨트롤러는 예비 블록 풀(Reserve Pool)이 고갈되는 시점에 비로소 SMART 원시값에 에러를 기록하므로, 05 번 카운트가 1이라도 올라온 시점은 이미 내부 예비 여유가 크게 감소했음을 의미합니다.
반면 C7(CRC 오류) 속성은 과거 누적 기록이 유지되는 특성이 있습니다. 이전 케이블 불량으로 한 번 카운트된 숫자는 케이블을 교체해도 0으로 리셋되지 않으므로, 절대적인 숫자 크기보다 '최근 시스템 사용 중 원시값이 매주 추가 증가하는지 여부'를 관찰하여 케이블 교체 및 포트 변경 조치를 취해야 합니다.
NVMe M.2 SSD 진단: 가용 예비 공간과 미디어 오류 분석법
PCIe 인터페이스 기반 M.2 NVMe SSD는 NVM Express 공식 표준에 정의된 통합 헬스 리포트 구조를 채택하고 있습니다. SATA의 05, C5 속성 대신 NVMe 전용 텔레메트리 파라미터가 제공되므로, 진단 시 점검해야 할 항목의 정의가 완전히 다릅니다.

| NVMe 진단 항목 | 안정 기준 수치 | 필드 해석 및 장애 판단 기준 |
|---|---|---|
| Critical Warning (중요 경고) | 0 | 0x00이 아닌 플래그 발생 시 장치 자체 결함(예비 공간 부족, 온도 임계 초과, 내부 미디어 오류 등) 선언 상태 |
| Available Spare (가용 예비 공간) | 100% 시작 | 불량 블록 대체용 여유 영역 잔여율. 임계값(통상 10%) 이하로 하락 시 컨트롤러가 쓰기 방지(Read-Only) 모드 전환 준비 |
| Media and Data Integrity Errors | 0 | ECC 엔진이 정정하지 못한 치명적 데이터 무결성 오류 횟수(SATA C6 동급). 원시값 1 이상 시 즉각 교체 대상 |
| Percentage Used (사용량) | 0 ~ 100% | TBW 대비 사용 소진율. 100% 도달은 보증 만료를 뜻하며, 다른 에러가 없다면 즉각 교체 사유는 아님 |
| Unsafe Shutdowns (비정상 종료) | 누적 참고치 | 정전 및 강제 전원 차단 횟수. 윈도우 빠른 시작(Fast Startup) 동작 특성상 누적될 수 있어 단독 고장 판정 불가 |
| 온도 경고 누적 시간 | 0에 수렴 | 스로틀링(성능 다운) 동작 온도 임계치를 초과하여 구동된 누적 시간. 방열 솔루션 점검 기준 |
NVMe 규격에서 가장 결정적인 하드웨어 경보선은 'Available Spare(가용 예비 공간)'가 제조사 지정 임계값(기본 10%) 미만으로 떨어지는 순간입니다. Percentage Used 수치가 10% 미만으로 거의 신품 수준이라도 가용 예비 공간이 100%에서 지속 하락하고 있다면 낸드 다이의 결함으로 예비 블록이 급속히 소모되고 있는 것이므로 보증 기간 내 무상 교환을 접수해야 합니다.
고성능 NVMe SSD 컨트롤러는 고부하 작업 시 50~60℃를 상회하는 것이 일반적입니다. 내장 열 제어 루틴은 통상 70~80℃ 구간에서 스로틀링을 개입시켜 과열 손상을 방지하므로, 단순 파일 복사 중 일시적으로 기록되는 60℃대 온도는 정상 범주입니다. 단, 아이들(IDLE) 상태에서도 70℃를 초과한다면 서멀 패드 밀착 불량이나 M.2 방열판 누락을 확인해야 합니다.
수명 98% 상태의 급사 메커니즘과 장기 보관 데이터 손실 한계
SSD 고장 패턴은 서서히 셀이 마모되는 점진적 노화와, 사전 징후 없이 드라이브가 인식 불능(벽돌) 상태가 되는 '급사(Sudden Death)'로 명확히 나뉩니다. SMART 모니터링 시스템은 점진적 낸드 마모는 정밀하게 추적하지만, 컨트롤러 프로세서 냉납, DRAM 캐시 손상, 펌웨어 패닉 버그에 의한 급사는 사전에 탐지하지 못합니다. 전날까지 건강 상태 98%로 표기되던 SSD가 익일 메인보드 BIOS/UEFI 장치 목록에서 완전히 사라지는 현상이 발생하는 기술적 배경입니다.

실제 엔터프라이즈 환경에서도 펌웨어 결함에 의한 집단 급사 사례가 확인된 바 있습니다. 2020년 휴렛팩커드 엔터프라이즈(HPE)는 자사 SAS SSD 제품군에서 누적 가동 시간 32,768시간(정확히 3년 9개월 8일)에 도달하는 순간 펌웨어 내부 카운터 오버플로우로 인해 드라이브가 영구적으로 먹통이 되는 치명적 버그를 공지하고 긴급 패치를 배포했습니다. 마모도 지표는 100% 무결점 상태였으나 컨트롤러 작동이 중단되며 데이터가 영구 손실되었습니다.
플래시 메모리의 물리적 데이터 보존력(Data Retention) 한계 역시 간과하기 쉬운 급사 요인입니다. 국제 반도체 표준 협의 기구(JEDEC)의 클라이언트 SSD 표준 규격에 따르면, 보증 수명 한계에 도달한 SSD는 상온 30℃ 무전원 보관 조건에서 '최소 1년간의 데이터 보존'을 만족하도록 규정되어 있습니다. 신품 상태에서는 수년간 전원 공급 없이도 전하가 유지되지만, 장기간 쓰기 작업이 누적된 SSD를 PC에서 탈거하여 외장 백업 용도로 서랍 속에 수년간 방치할 경우 절연막 전하 누설로 인해 데이터 파티션 손상이 발생할 수 있습니다.
따라서 SMART 리포트는 백업을 완전히 대체할 수 있는 만능 안전장치가 아닙니다. 원시값이 0으로 깨끗한 드라이브는 정기 백업 간격을 여유 있게 운용하고, 경고 수치가 1이라도 감지된 드라이브는 당일 최우선 백업 및 교체 대상으로 전환하는 '작업 우선순위 선별 도구'로 정의하는 것이 실무적으로 올바른 접근입니다.
현장 진단: 수치 조합별 5대 실전 판정 및 교체 매트릭스
실무 현장에서 접하는 SSD 진단 결과는 단일 파라미터가 아닌 여러 지표의 조합으로 나타납니다. 대표적인 5가지 수치 조합 패턴을 분석하여 교체 필요 여부와 대응 절차를 제시합니다.
- [케이스 1] 잔존 수명 92%, 05·C5·C6 원시값은 모두 0이나 C7(CRC) 수치만 매주 지속 증가: 드라이브 자체는 물리적으로 정상입니다. SATA 데이터 케이블의 노후화, 커넥터 핀 접촉 불량, 파워서플라이 SATA 전원 케이블 간섭이 원인이므로 케이블을 교체하고 메인보드 다른 SATA 포트에 재체결하십시오. 데이터는 손상되지 않은 상태입니다.
- [케이스 2] 잔존 수명 99% 표기, 건강 상태 '주의', 원인은 C5(보류 섹터) 원시값 8 기록: 마모가 아닌 낸드 다이의 국소적 하드웨어 셀 불량입니다. 신품 구매 직후라도 불량 블록이 발생한 상태이므로 즉시 중요 데이터를 복사하고 제조사 RMA 또는 공식 유통사를 통해 무상 A/S 리퍼 교환을 진행해야 합니다. 8에서 카운트가 멈춰도 언제든 전손 위험이 있습니다.
- [케이스 3] NVMe 드라이브, 사용량(Percentage Used) 104%, 예비 공간 100%, 미디어 오류 0: 보증 기준 TBW를 초과했으나 가용 예비 블록과 전송 무결성은 완벽히 유지되고 있습니다. 즉시 폐기할 필요는 없으며, OS 부팅 드라이브 역할을 신규 고속 NVMe에 인계하고 단순 게임 설치나 비중요 임시 작업용 보조 스토리지로 강등 전환하여 활용하는 것이 경제적입니다.
- [케이스 4] 간헐적 부팅 디바이스 누락 및 윈도우 프리징 발생, 그러나 SMART 수치는 전 항목 정상: 컨트롤러 낸드 채널 통신 단절 또는 전원부 강하로 인한 전형적인 급사 전조 증상입니다. 벤더 전용 툴(삼성 매지션, SK하이닉스 드라이브 매니저 등)로 최신 펌웨어를 즉시 업데이트하고, 동일 증상이 재발할 경우 SMART 정상 판정과 무관하게 즉시 신품으로 교체해야 합니다.
- [케이스 5] 누적 총 쓰기량 40TB, 실사용 3년, 잔존 수명 96%: 일반적인 데스크톱 작업 환경에서 매우 건전하게 운용된 상태입니다. 산술적으로 수십 년의 내구도가 잔여하므로 교체 고려 대상이 아니며 통상적인 시스템 운용을 지속하면 됩니다.
SSD 내구성 극대화를 위한 시스템 세팅 및 유지관리 수칙
SSD의 수명을 물리적으로 연장하고 급작스러운 속도 저하(I/O 지연)를 방지하기 위해서는 비효율적인 레거시 튜닝을 지양하고 올바른 시스템 환경을 세팅해야 합니다. 공학적으로 입증된 6대 하드웨어 최적화 수칙을 준수하십시오.
| 관리 영역 | 실무 설정 및 엔지니어링 실천 수칙 | 하드웨어 수명 및 안정성 기대 효과 |
|---|---|---|
| 여유 공간 확보 | 전체 파티션 용량의 10~20%를 항상 빈 공간으로 유지 | 컨트롤러 가비지 컬렉션(GC) 공간 확보, 쓰기 증폭 계수(WA) 감소 |
| TRIM 프로토콜 | 윈도우 '드라이브 드라이브 최적화' 주 1회 자동 실행 활성화 확인 | 삭제 블록 무효화 사전 정리로 낸드 쓰기 지연 및 마모 편중 방지 |
| 발열 및 쿨링 | M.2 알루미늄 방열판 장착 및 PC 케이스 전면 흡기/후면 배기 통풍 유지 | 컨트롤러 열화 억제, 70℃ 이상 스로틀링 진입 빈도 차단 |
| 펌웨어 유지보수 | 제조사 공식 전용 관리 소프트웨어로 최신 펌웨어 버전 상시 유지 | 알려진 컨트롤러 패닉 버그 및 데이터 테이블 유실 오류 방지 |
| 불필요 I/O 분리 | 토렌트 다운로드 경로, 대용량 임시 가상머신 캐시를 보조 드라이브로 지정 | 부팅 드라이브 낸드 셀의 불필요한 P/E 사이클 소진 차단 |
| 다중 백업 구축 | 외장 스토리지 1벌 + 클라우드 스토리지 1벌의 3-2-1 백업 규칙 유지 | SMART 미검출 급사 및 랜섬웨어 감염 시 완벽한 데이터 회수율 보장 |
주의할 점은 윈도우 환경에서 과거 HDD용 서드파티 조각 모음 유틸리티를 강제로 구동하는 행위입니다. 윈도우 내장 최적화 기능은 SSD 감지 시 조각 모음 대신 TRIM 명령어를 전송하도록 설계되어 있습니다. 강제 조각 모음은 수만 번의 불필요한 블록 쓰기만 가중시켜 TBW를 급속히 소모시킵니다. 마찬가지로 SSD 수명을 아끼기 위해 가상 메모리(페이징 파일)를 비활성화하는 트윅은 시스템 메모리 부족 시 충돌(BSOD)을 유발하므로 권장하지 않습니다.
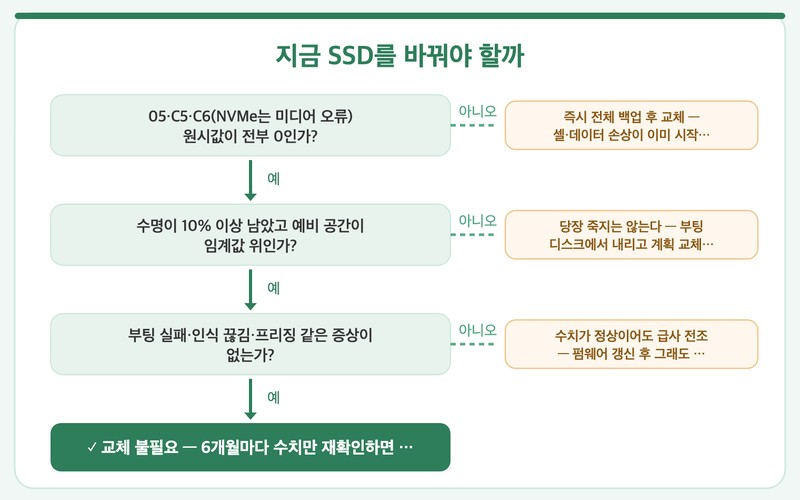
SSD 건강 관리의 본질은 수명 퍼센트라는 추정 지표에 일희일비하는 것이 아니라, 치명적 하드웨어 결함을 지시하는 원시값(05·C5·C6, Media Errors)과 물리적 가용 예비 공간(Available Spare)을 주기적으로 추적·관찰하는 데 있습니다. 표기 수명이 90% 이상 남아 있어도 불량 섹터 원시값이 1 이상 기록되었다면 즉시 드라이브 교체 및 데이터 이전을 실행해야 합니다.
컨트롤러 급사와 펌웨어 오류는 사전 SMART 경고 없이도 발생할 수 있으므로, 주기적인 펌웨어 점검과 더불어 외장 드라이브 및 클라우드를 활용한 3-2-1 다중 백업 체계를 유지하는 것이 하드웨어 장애로부터 귀중한 데이터를 안전하게 보호하는 유일한 해법입니다.